Сначала я пытался купить готовый рынок
До Market Scan я семнадцать лет работал со списками, Sales Navigator, базами, поиском контактов и холодным аутричем. Только LinkedIn за это время получил от меня $20,196. Я долго считал, что хороший фильтр и дорогая база дают рынок. На деле они давали ответ только на тот вопрос, который я уже умел сформулировать.
В начале сентября 2025 года я сформулировал правило, к которому потом возвращался при каждой переделке: хороший результат начинается с исследования, иначе машина уверенно реализует один случайный вариант из миллиарда.
блин реально спасибо чуваки, я супер вдохновлен, и мне кажется я сейчас снесу нахуй все что я навайбкодил до этого И забацаю настоящего пиздатого бота Что я понял уже три раза подряд за последние 2 дня Вайбкодинг это в первую очередь про рисеч =) Поскольку вайбкодинг может охуенно в сущности кодить Но кодить можно бесконечным числом способов Как и писать тексты по теме длиннее 10 слов И пока ты не сделал свой охуенной глубокий рисеч - вайбкодинг дает лишь один из миллиарда вариантов развития событий, далеко не оптимальный А вот если рисеч проведен реально хорошо - можно ограничить в рамках этого рисеча, и получить нечто оптимальное. Оптимизация вайбкодинга, получается, это оптимизация рисеча) И для рисеча как раз идеально иметь некий форум голосов, потому что когда ты рисечишь один на один с сетью, ты очень-очень-очень быстро ловишь bias А вот когда 100 человек перед твоими глазами файтятся между собой по теме и выдают десятки и сотни своих вариантов, bias передергивается раз в секунду, и движение к подходящему сценарию происходит ГОРАЗДО быстрее
Через две недели я ещё делал глубокий разбор рынка вручную. Чтобы понять одну компанию, мне приходилось раскладывать весь рынок, его деньги, участников, мотивацию и противоречия. Разбор Creator Economy хорошо показывает, какой объём работы я тогда держал в голове.
Многие знают что я гордо состою в чатике для пиздец модных влоггеров-миллиардников, но не многие знают что я там отвечал на комментарий кента, который спросил у сообщества мол есть ли смысл вкладываться в потенциальное IPO компании Spotter, и поскольку я дохуя писал в ответ, и этот ответ это по-сути тоже контент, я ебашу копию еще и сюда, чтобы те из вас, кому щекочет пиписю элементарная мысль о стартаперстве в рынке Creators Economy подумали еще разок-другой прежде чем в это озеро нырять. Ведь это не просто озеро, а озеро собачьей спермы: Моя жена последние 6 лет работает Director of Business Development в TikTok UK, и как-то в конце 2022 - начале 2023 запрыгнула на сайд-хассл миноритарным кофаундером к Дане Гальперу (основатель Growfood) в проект Fundmates (его новая ставка с 2022 года, тоже выдают кредиты/выкупают монетизацию инфлов) - строить и возглавлять продажи, чем занималась около 9 месяцев. Срулила потому что стало понятно что там ничего хорошего уже не будет (так и получилось).
С доступом к базе TikTok и с Look&Feel Senior сотрудника Bytedance забивать пайплайн диалогами с креаторами - вообще не проблема. За 4 месяца раздали первый лям долларов ну очень тщательно отобранным креаклам. Диалогов было море, сотни креаторов (с миллионами подписчиков) в месяц.
Как это на деле превращается в бизнес модель... Технически это вообще трудно классифицировать как бизнес, это хаотичный джаглинг деньгами туда-сюда, с потерей сквозь пальцы почти всего их объема в процессе :D
Как устроен данный рынок (и почему он гнилой)
Условно можно разделить на два лагеря:
Лагерь первый - Spotter и подобные. Действуют как музыкальные лейблы. Заходят не просто с деньгами (как кажется на берегу) - они навязывают свой продакшен и дистрибуцию. Они конечно могут просто выкупить контент, если ты условный Снуп Дог. А если не столь великий - будешь въебывать под руководством их менеджмента, потеряешь суверенитет. Будут натурально говорить что нужно делать и как это нужно делать, тыкая в договор.
Кстати, Spotter с 2019 года раздал (по их словам) $940 миллионов креаторам, хотя поднял сам не больше $500М венчурных денег (везде пиздеж). И... Уже в ноябре 2024, сразу после партнерства с Amazon, начали активнейше увольнять людей. Это не просто подготовка к IPO - это на публично доступных цифрах выглядит как режим выживания, а необходимо для здравия держать в уме что публичные цифры всегда ещё и очень дутые.
Лагерь второй - CreativeJuice, Fundmates. Выкупают 14-25% будущих доходов с ежемесячным расчетом. Guest account для контроля, чтобы избежать шейвинга (это когда креатор прячет/занижает доходы). На бумажке всё красиво. На деле всё сложно:
1. Невозможно стандартизировать креаторов
10 влогеров с 3М подписчиков = 10 абсолютно разных экономик. Комплаенс пытается категоризировать этих оболтусов, но картина со временем становится не чётче а наоборот - размытее. Идеальных по чеклисту практически нет. А те немногие кто в эту когорту по чекбоксам попадает - сами все понимают и прямо говорят: "Нафига мне ваш лям за 20-30% в год годами, если банк даст под 7-10% TOTAL?"
Компромиссы в отборе ломают модель. Но без них не работает дистрибуция. А венчуристам нужен экспоненциальный рост, иначе они дергают рубильник не копаясь в деталях, особенно в нынешней сутулой экономике.
2. Человеческий фактор (реальные кейсы)
Из маленькой выборки Fundmates: выгорания, алкоголизм, проигрыш канала в казино. Купил креатор дом на аванс - и его цели резко изменились, теперь он хочет шить панамки из соломы на Бали. Это не шутки.
По индустрии - 52% креаторов испытывали выгорание годами, 37% мечтают совсем уйти и заняться чем-то другим. 55% называют финансовую нестабильность главной причиной. Редкий успех сменяется непредсказуемо длинной чередой неудач.
3. Временной арбитраж
Креаторы прекрасно знают свой burnout timeline. Берут деньги, понимая что через полгода пивот или лив. Это информационная асимметрия, которую никто не обсуждает. Ну очень большой процент креаторов используют эти "кредитные" платформы просто как банкоматы халявных денег перед уходом.
4. Мошенничество везде, креаторов банально наебывают.
Кроме наебалова от откровенных фродстеров, есть еще агентства которые пытаются зачарджить с креатора % за бренды которые он привел к себе сам, под предлогом эксклюзива, который распространяется типа на всё. Креатор либо теряет эти % (тобишь больше половины маржи), либо ссорится с агентством, но тогда получает дырку в монетизации, которую раньше хотя бы отчасти закрывало это агентство.Но кредитная организация-то считала свои формулы за секунду ДО того как все это произошло)
5. Данные - полный пиздец Adverse selection - креаторы с ботами выдают себя за настоящих. Платформы работают с third-party data scraping - неточные, неактуальные данные. Никто не знает реальную стоимость креатора. Ну очень многие научились копировать look&feel успешных креаторов, не являясь таковыми. Им активно помогают в этом агентства, которые зарабатывают на креаторах, и заинтересованы в "сговорчивых" креаторах, которые когда надо будут заполнять любые саплай дырки в энтерпрайз бюджетах своими лживыми тушками. А для кредитной-то организации (особенно для их наемного персонала который креаторами не является) они по визуальным и easy scannable метрикам выглядят плюс-минус так же как и реальные креаторы.
6. Платформы издеваются
Meta вместо денег выдает "виртуальные бейджи" - meaningless metrics чтобы отвлечь от отсутствия выплат. "Смотри, у тебя теперь золотая звездочка!" X может заблокировать выплаты по любой причине включая "подозрение". Без объяснений. Твои деньги? А хуй. Я думаю тут люди собрались такие которым не надо уж точно объяснять что способны выкинуть платформы =)))
И это не полный список того, почему Spotter/CreativeJuice/Fundmates/etc не вернут себе вложенные в львиную долю креаторов деньги. А один невозврат перечеркивает Х возвратов. А все они существуют на венчур (самые дорогие деньги в природе), поэтому этот Х можно еще смело умножить на 10 а то и 20.
Динамика инвестиций (готовьтесь плакать)
2021: $500М в квартал в США, $5B за год - пик ZIRP-безумия
2023: США $1.03B (падение 62%), глобально $1.7B (падение ШОК%)
2024: "восстановление" до ~$900M за счет AI-хайпа, но это все равно в 5 раз меньше пика, и AI-хайп это AI хайп. Можно сказать что прошлое померло совсем, и мы новый вообще сегмент теперь на этом месте считаем.
С 2021 года в индустрию глобально закачали $19+ миллиардов венчурных денег. Возврат? Да практически ноль.
Fundmates за 3 года не вышел из абсолютных убытков. При всех связях и доступах, сханченных людях и пайплайне из тысяч креаторов, которые активно коммуницировали.
Jellysmack (SoftBank-backed!) - три волны увольнений подряд, ребята потеряли 80% сотрудников или 800 человек. Я после текста закину скрин который заставит ужаснуться даже слепого. Мертвее компанию надо еще поискать)))
Spotter режет команду после Amazon-дила!!! Треть компании и половину сейлзов/биздевов вышвырнули - в такой модели это означает только одно: абсолютно нихрена не получается. При этом собираются на IPO с обещаниями 2x MOIC и 18% IRR? Ну-ну =)
С креаторами бесполезно судиться:
Во-первых судиться это как бы очень дорого и долго. Венчурные стартапы не построишь на модели "засуди своих клиентов". Во-вторых тут важно кто клиенты. Судиться в этом рынке это репутационный суицид. "Злая корпорация душит маленького креатора" - заголовки сами напишутся. Даже если креатор взял деньги и просто исчез послав всех нахуй (что делает больше половины, и желание так поступить было единственным драйвером в принципе войти в сделку).
Машка потрещала с десятками крупных влогеров уже после своего Fundmates Endeavour. Они относятся к этим платформам с полным цинизмом. Это банкоматы, не партнеры. Взял деньги - забыл. Никакой лояльности.
Многие даже сходу не понимают реальную экономику сделки - видят gross revenue, забывают про self-employment taxes, отсутствие healthcare, 401k, вложения которые нужны в обеспечение роста, который обещали в обмен на "кредит". Когда всё это реально считается уже после сделки - настроение креакла меняется на противоположное очень быстро, даже в редких случаях когда изначально оно было вдохновенным. Следующий шаг - меняется еще сильнее/быстрее после того как первое вложение не оправдалось (можно наэкспериментировать на лям, ни один эксперимент не выстрелил, а платить 30% от всех своих доходов все равно придется хнык-хнык).
Ребята из Spotter нынче, видимо, находятся в правильном месте с достаточным бэкграундом чтобы надуть пузырь больше других. Дуют изо всех сил, аж легкие рвутся.
Один топовый венчурный инвестор в начале года сказал: "Judgment day is already here for all these pseudo financial companies". И он прав. Creator financing - это попытка применить традиционный финансовый инжиниринг к хаосу человеческого творчества. Как банчить деривативами на чье-то настроение.
За 4 года сожгли $19 миллиардов на идее что можно институционализировать непредсказуемых людей с камерами, на многослойном рынке сбыта, где каждый слой мечется.
Так что когда вам предлагают pre-IPO Spotter с "гарантированным" удвоением - это попытка найти последнего дурака перед схлопыванием. Очень кстати популярная история =)
Параллельно я возвращался к своим ранним текстам об AI. Ещё в 2023 году я видел главную проблему: модель может ускорить письмо, но не заменит вкус, исследование и способность собрать коммерческий аргумент из десятков разрозненных фактов.
Там сразу две проблемы, получается. Во-первых, улучшать ноль - все равно что умножать на ноль. Ну и что что шайтан-машина эта заморская перефразирует триста символов говна? Я рот ебал вы чо не понимаете что до тех пор пока мясная прослойка между клиентом и банковским счетом физически существует, человеческое неотчуждаемо? От того что обезъяна установит себе фотошоп, она коммерческой художницей типа не станет? И даже если стэйбл дифьюжен воткнет, все равно не станет. Обезъяне сперва надо стать человеком, который хотя бы виндоуз переустановить может. Если человеку нравится читать Донцову, он сходит в самую необъятную библиотеку мироздания, и попросит там Донцову, а от Канта у него башню распиздрычит быстрее чем он оглавление дочитает. Почти все сейлзы пишут хуйню, а значит они и удовлетворятся хуйней, которую им напишет хоть жипити, хоть сам лично боженька. Вы сейлзами когда-нибудь управляли йоу?
Умение писать продающие тексты - это не хуй знает что, а вкус к продающим текстам, бизнес-моделям, идеям продуктовой интеграции, итд. Вкус состоит из врожденного, и приобретенного с опытом, где второе на порядок важнее первого, хотя, согласно статистике, и первым боженька шибко щедро не разбрасывался, а без первого второго не случится.
Возьми десять кентов, и дай им одну задачу: написать продающее письмо по продукту Х, для которого надо взять информацию из вот этих шести файликов, а так же лендоса, кранчбейса, дэйты LinkedIn Premium Insights, обсуждений с Реддита, проворного гугления, и откуда-нибудь ещё, и продать это бизнесу Y, о котором так же надо все читануть во всем перечисленном. Получишь на выходе десять принципиально разных вариантов. У пиздатых кентов (0,02%) - с переменным успехом потенциально рабочих (проверить боем предстоит, и не раз еще переделать). У типичных нынче (99,98%) - никчемных, фейспалмных, им ничто уже не поможет. Первым GPT поможет где-то быстрее словоформы родить стилизованные, где-то тупо грамматику причесать. Пять часов работы над текстом превратит в два. Вторым - поможет только с грамматикой, но не она блядь продает как бы.
ПрофессАнал в продажах не пишет письма. Он их собирает пословно, как паззл, в зависимости от уймы факторов, которые он высматривает во всех этих там тулзах всяких и прочей ебанине, ещё в своём опыте, и в разговорах со знающим другом, и тэ дэ. Хули из этого Chat GPT3 может сделать?
Все бегают и гордятся тем что они ЗАПРОС ИНТЕРЕСНЫЙ блядь в строку ввода написали, и получили не ИДИ НАХУЙ, а аж целый блядь НЕКИЙ ОСМЫСЛЕННЫЙ ТЕКСТ! Ну все, охуеть теперь, ВОТ ЭТО ДА!!!!
К октябрю проблема баз стала совсем очевидной. Даже связка Apollo и Clay не показывала весь рынок. Она дорого очищала часть уже известного мира, но не находила то, что не помещалось в исходные фильтры.
Ну и чистота с каждой тысячей следующих будет падать, а потом окажется что на рынке 50к например нужных компаний существует, а в аполло есть только 20к, с уймой нерелевантных уже давно людей (хотя аполло уверены что все релевантно, все галочки будут зелеными) Короче оч грязная хуета :)) Оно в начале пути было пизже сильно, потом они плохо сдюжили доэнрич и апдейт базы Вероятно потому что большинство людей даже не поймут о чем я выше написал И покупают и так :)))
В феврале я упёрся в предел инструментов
К февралю 2026 года у меня не осталось иллюзий насчёт готового стека. Инструменты были полезными, но каждый из них решал маленький кусок задачи. Вместе они превращались в дорогую цепочку, где мусор одного шага умножал цену следующего.
в двух словах:
Говно ебаное
Но за неимением лучшего - охуенные тулзы!
Apollo попроще но только если вручную шлешь, потому что автоматику качество контактов из аполло угандошит за неделю По LinkedIn Helper надо получить нобелевскую премию Тулзы для авто-рассылок по ТГ проще и лучше всего, особенно если ты криптан Криптанам все что в телеге сразу дает +5 к удаче
findymail будто тебе нормальные почты найдет) Там угадайка
Получится правда невменяемая цена контакта Но проблема не только в этом А еще в том сколько у тебя в итоге чистых контактов будет на выходе Качество базы настолько ебаное что 1000 контактов чтобы получить иной раз надо через эту связку прогнать 20к Это во-первых удорожает производство в 20 раз, но это ладно хотя бы за деньги покупается Но самое страшное - во-вторых Это делает из любой вертикали маленькую Попробуй поискать например владельцев Арт Галерей (как пример проблемной вертикали) Довольно не трудно найти 650 тысяч арт галерей Но в итоге ты найдешь за бешенные бабки 1000 владельцев =) С баунцом ~5%
Я перестал искать одну волшебную базу. Стало понятно, что систему придётся собирать самому: брать данные из разных мест, проверять их, дедуплицировать, обновлять и пускать по ним агентов.
вайбкодинг + букет апишек Я не знаю как это внутри у Clay, но знаю что у них это дорого пиздец.
Мы можем в любой категории найти десятки-миллионы контактов с clarity 100%, дедуп/дебаунц/итд позитив. десятки или миллионы зависит от фильтров Clay на самом деле ничего такого сверхъестественного не сделал. Они просто были первые и зарейзили ДОХУЯ лавэ) Сами тоже тягают дату отовсюду, как и все любой поиск контактов это вечно растущая гора апишек Ну и опять же когда Clay это делал это наверно еще было круто Сегодня просто каждый школьник может всосать данные и гулять по ним армией агентов не каждый школьник найдет денег энтузиазма и понимания как это монетизировать правда)
В этот момент задача впервые стала похожа не на покупку списка, а на самостоятельное производство знания о рынке.
Весной из этой проблемы начала расти система
В марте я сформулировал, что продавать абстрактный потенциал больше нельзя. Нужен был путь от фактов о бизнесе к рынку, от рынка к проверяемой гипотезе, от гипотезы к конкретному коммерческому предложению.
Рынку сегодня вообще плевать, что у тебя “есть”. Рынку важно, понимаешь ли ты настолько глубоко конкретный сегмент, чтобы назвать то, что у него болит, ещё до того, как он это сам вслух сформулировал.
Причём не в формате: “кажется, у вас может быть challenge”. (Пиздец нахуй блядь уроды бизнес это и есть Challenge. Когда ты пишешь бизнесу что догадываешься что у него где-то challenge, ты даже тест Тюринга не проходишь, до IQ ещё очень далеко.)
А в формате: “мы точно знаем, где у вас сейчас утекают деньги, где ломается юнит-экономика, где качество недостаточно, где скорость не та, где контроль размазан, где у вас воронка притворяется рабочей”. Вот тогда появляется шанс на response rate 1% и выше. Вот тогда появляются созвоны. Вот тогда сделки хотя бы получают право на практическое существование.
И даже это, кстати, ещё не победа. Мы регулярно заваливаем клиента СОТНЯМИ целевых лидов, к которым они не могут вообще никак прикопаться - типа идеальные лиды. Но сделок из них они закрыть не могут. Потому что дальше всё равно будет экономика. Будет способ деливери. Будет жёсткость SLA. Будут риски. Будет внутренний ресерч. Будет юрчасть. Будет между всеми этапами повторяться вопрос “а точно ли оно нам надо?”.
То есть продажа сегодня это уже не “написал хорошее письмо и закрыл”. Продажа сегодня это многоэтажный ебучий квест, где на каждом этаже тебя могут развернуть по новой причине.
И поэтому когда я вижу у кого-то слабые конверсии в outbound, мне как человеку, который давно сидит на стороне sender’а, обычно довольно очевидно, что проблема не в “рынок сложный”.
Проблема чаще в том, что вы сами недостаточно глубоко понимаете, что именно продаёте.
Это как писать: “Разработка под ключ, в том числе ML и еще пятнарик словечек помоднее”.
И что? Кому? Зачем? Почему именно этому банку? Почему именно этому директору? Почему именно сейчас? В чём смысл для него, кроме того, что вы опять хотите откусить кусок его внимания?
Сейчас все настолько перегружены офферами, что людям не хватает времени даже на реально золотые предложения.
Здесь есть важное различие, которое многие не понимают.
Хорошая outbound-команда действительно может сделать из хорошего оффера золотой.
Но она не может сделать золотой оффер из _хуйни_.
Потому что физику не обманешь.
Если у тебя внутри пустота, никакая риторика, никакая персонализация, никакой “noticed your recent funding round” не превратят это в _деньги_.
У меня есть два знакомых, которые продают логистический софт.
Один ходит по рынку и говорит: “Мы продаём софт для логистических компаний”.
И сосёт хуй.
Второй ходит и говорит: “Мы точно знаем, что ваши конкуренты прямо сейчас покупают решение за $20 млн, вот доказуха. Мы можем дать вам тот же стратегический эффект за $1 млн”, ещё и без операционки по внедрению, вот доказуха.
И вот тут рождается магия. Если Покупатель сейчас в правильной точке, Покупатель перестаёт “терять миллион на этой покупке”. Он начинает “зарабатывать или сохранять девятнадцать миллионов”, благодаря тебе.
То есть ты больше не продаёшь софт. Ты вообще никогда не продаешь больше софт. Никому нахуй не нужен твой софт. Ты продаёшь исключительно конкретную экономическую развязку. Ты продаёшь не функцию, а изменение финансовой реальности. Ты влияешь на отношения внутри и снаружи чужой борды.
И вот там начинаются настоящие сделки.
Но есть критически важный нюанс.
Этот нельзя высосать из пальца. Вы не можете сесть командой и НАБРЕЙНШТОРМИТЬ доменную реальность. О ней только можно либо знать, либо не знать. А когда о чем-то знаешь, об этом можно только плохо или хорошо рассказывать. А когда умеешь хорошо рассказывать, об этом можно рассказывать одному человеку в месяц, а можно десяти в день.
Люди, которые тратят серьёзные деньги, не идиоты. Даже если кажутся такими - ключевое слово "кажутся".
Но сейчас есть ещё одна проблемка, о которой чето я не вижу чтобы кто-то думал или говорил.
После популяризации GPT продавать стало ещё в разы тяжелее.
Потому что теперь в сделке почти всегда сидит ещё один невидимый участник.
Раньше у тебя был buyer. Потом buyer + его команда. Потом buyer + его команда + рыночная экосистема. Теперь buyer + его команда + рыночная экосистема + у каждого из этих мразей гениальный GPT, который за 5 минут делает ресерч и очень часто выносит вердикт примерно такой:
“Не надо это покупать. Это дорого. Это весьма сомнительно. Это вам нахуй не нужно”.
И всё.
То есть если раньше ты мог проскочить на харизме, на презентации, на красивой легенде, на “ну мы вроде солидные ребята”, то теперь рядом с покупателем стоит цифровой ублюдок, который не устает, не ленится и очень быстро вскрывает, где у тебя вода, где натяжка, а где просто ебаный bullshit на деловом костюме. Поэтому продавать в 2026-м надо так, чтобы даже GPT клиента был на твоей стороне.
Чтобы если клиент пойдёт советоваться с моделью, показав твои вводные, она не сказала: “дорого, мутно, необязательно”.
А сказала: “да, в этом есть смысл”. “да, это бьёт в реальную задачу”. “да, тут понятная экономика”. “да, это похоже на правду”. "да, это одно из лучших предложений из моего рисеча".
Вот к чему всё УЖЕ пришло.
Сегодня выигрывает не тот, у кого “есть решение”. И даже не тот, у кого “лучший продукт”.
Выигрывает тот, кто умеет настолько глубоко понять сегмент, что формулирует ценность лучше, чем сам клиент сформулировал бы свою проблему.
Тот, кто продаёт не абстракцию. Не потенциал. Не “инновацию”.
А очень конкретный кусок денег, контроля, скорости, безопасности или преимущества, который клиент может буквально потрогать мозгом, причем не своим, а мозгом своего карманного гения.
В апреле я впервые описал этот путь как одну автоматизированную цепочку. К тому моменту я уже четыре раза переписал внутреннюю систему, заменял отдельные сервисы своим софтом и видел, как исследование, инфраструктура, письма и ответы могут работать вместе.
В смысле… Я в январе еще начал Я сначала сделал статфэйс глобальный который нам оч помог Потом взялся за автоматизации которые заменяли людей все больше и больше Всего было 4 реализации этого статфейса В последней он уже умел сотни вещей, например по щелчку из мной же написанной црмки подписывать контракт, слать инвойс, проверять все ли оплачено, когда да - тут же регать инфру, итд итп Когда заканчивался оплаченный период он ловил это и слал новый инвойс, пинговал если не присылают платеж Клиенты наши данные от нас с февраля получают только автоматом После четырех релизов переписываемой с нуля этой системы я понял что в целом я осмелевший уже вайбкодер И я решил начать убирать из связки поставщиков софта Потому что он и денег стоит, и неудобный, и не надежный, и без когерентности метафизики используемых кусков в бизнесе нереально сделать настоящую полную автоматизацию В итоге я сделал свой инстантли-лайк сендер Это ебать сложно было, но сейчас мы шлем только с моего сендера типа сотни тысяч писем У меня два человека осталось в бизнесе Мы вдвоем делаем больше чем раньше могли бы толпой из 80 чел К концу мая эта штука будет за нас работать сама по себе Я сейчас доделываю на втором сервачке уже совсем железном свою ферму доменов и ящиков по стандартам которые не способны дать поставщики Я всех перепробовал, но настоящее качество там есть только за какие-то совсем безумные деньги типа 50 баксов за ящик в месяц с прогревом и правильным маскированием всего на свете Но мне надо 400 ящиков на проекте В итоге я ща тестирую свою ферму Она умеет когда платеж пришел автоматом закупать у трех поставщиков (на случай отъеба одного или двух из них разом) 100 доменов Создавать под эти домены почты Ставить все это на прогрев Гонять все это по изолированным подсетям айпишников Реагировать на малейшие изменения статистики в сендере Ставить ящики на паузу на прогрев/расследование докупая новые тут же на случай дальнейшей деградации Итд итп Я др завтра фичи перечислять могу)) Ща вот наконец руки дошли свой докусайн довести до ума В итоге я хочу прийти к тому чтобы я чисто с клиентом брейнштормил и все записи этих брейнштормов сливались автоматом на NAS 130-терабайтный на шкафу Система оттуда забирала эти видосы, изучала их И на базе их уже дальше сама искала вертикали, сама создавала инфру, сама контролила приходы и расходы, сама под каждую вертикаль создавала контент, а/б/с/д- тесты, цепочки, контакты, следила чтобы везде все было всегда в достатке, а если что-то от нормы отходит - пиздила меня в телегу Оно в общем-то уже так и работает процентов на 85))) У нас например сейчас когда письма входящие приходят, у меня три проверки AI сортируют их, уже добился чтобы вообще без ошибок Все позитивные тут же форвардятся клиенту в ящик У моего AI всегда есть доступ к этому ящику Он проверяет что письмо туда дошло И потом мониторит что на него ответили сотрудники клиента Если нет - симафорит об этом в общий чатик) И считает среднюю скорость их реакции итд В целом улучшать можно бесконечно, фичи придумываются быстрее чем кодекс их ебенит) А AI умнеет, не за горами фича - общаться с лидами за сотрудников клиента :) А потом и вообще полный цикл можно будет автоматизировать С демками, итд. Судя по развитию нужных узлов - в этом году уже можно будет запилить я думаю)) Проблема людей кмк в том что они пытаются сесть и накодить им что-то что им денег принесет Но деньги не приносят товары Деньги приносит бизнес Бизнес - это много всего надо накодить, тысячу вещей только чтобы разогнаться Я поэтому и говорю постоянно мол бля хуярьте что угодно Не надо думать Одна вещь абсолютно бесполезна, никто ее у вас не купит, разве что пару раз за копейки Надо кодить все подряд, дохуя всякой шняги, и оно потом начнет как-то эмерджиться между собой) Плюс идеи лучше приходят не когда ты нихуя не делаешь А когда ты не можешь вспомнить когда ты последний раз нихуя не делал) Я оч надеюсь что 5.5 не отупеет как 4.7, и ускорит меня чтоб можно было скорее вырваться в кодинг чего-то за пределами этого безумия которое у меня уже на трех серваках живет)
К концу апреля масштаб изменился. AI уже позволял не выбирать одну красивую гипотезу и месяцами ставить на неё всё. Я мог собирать десятки и сотни направлений, писать под каждое отдельные серии и быстро получать данные о том, что действительно работает.
Я на самый конец оставил автоматизацию текстовых креативов а она там нужна, т.к. с помощью AI я теперь могу на старте проекта родить десятки или даже сотни гипотез И идеально было бы под каждую гипотезу сделать 8-шаговый набор креативов с 4 вертикалями a/b/c/d тестирования Вручную это невозможно себе даже представить Не существует такого отдела который я мог бы соркестрировать сделать такую задачу вручную Ни за какие деньги А вот AI можно настроить чтобы он это делал на сегодняшний день уже даже неплохо И это будет пизда скачок в эффективности опять Потому что сегодня я делаю пиздатый текст и добываю под него 8-10к контактов, и ставлю на это ставку Типа вынужден ставить Потом я запускаю второй так же, потом третий Это медленно, и сработать может даже не пятый, а восьмой например Это трагедия А тут можно будет в первый же месяц уже четко понимать как выстраивается дойка всех возможных вертикалей кастомеров на следующий год На базе реальной даты АВТОМАТОМ Это пиздец
Тогда же я впервые записал весь желаемый путь целиком. В нём Market Scan был уже не отдельным отчётом, а началом непрерывной системы, которая получает материалы клиента, исследует рынок, строит гипотезы, находит людей, пишет кампании и возвращает ответы в общую память.
Я успокоюсь когда флоу будет ровно так работать безошибочно:
Клиент платит - платеж поймали - создали воркспейс - зарегали автоматом инфру и поставили греться - запустили диприсеч всего что связано с бизнесом клиента т.к. известен его домен - запустили диприсеч всего что связано с бизнесами конкурентов и их клиентов и клиентов их клиентов - всё это смержили в конкретную базу по клиенту (мы сейчас здесь) - созвонились с клиентом поговорили, полученный колл закинул тупо файлом в воркспейс клиенту - база дополнилась - когда все чекбоксы заполнены - появилось облако гипотез - краулер собрал контакты под каждую гипотезу и чекнул их вотерфоллом для 100% сходимости - AI написал по 4 версии письма и по 4 версии А/Б-тестов до 8го шага - AI создал кампании по первым 50 верткиалям, заполнил их контентом и контактами, и запустил открутку писем - все входящие письма пересылаются клиенту и отображаются на всех дашбордах со всеми нужными сведениями о человеке, компании, индустрии это V1 V2 должна автоматом переписываться с лидами доводя их до звонка и потом ведя после звонка V3 должна автоматом проводить звонки...
Через два дня я записал и обратную сторону этой скорости. В феврале и марте неудачный луп мог оставить после себя систему, которую легче написать заново. К концу апреля я уже научился вести два разных проекта непрерывным конвейером и не повторять каждый такой провал.
Разгоняемся, ребяты. Конец марта и начало Апреля научили меня хуярить сразу фронт, бэк, серверную, и точечные, непрерывным конвейером для двух проектов одновременно на двух абсолютно разных по свойствам серваках, и делать это практически без ошибок.
В феврале-марте я помнится частенько гонял луп-промпты, часть из которых оказывались несостоятельными, и к моменту когда я это понимал уже можно было в целом начинать писать с нуля, потому что разгрести тот гадюшник было в принципе невозможно.
Если вы сейчас здесь, то продолжайте - скиллуха придёт) За последние 3 недели у меня ни разу не было ни одного затяжного забега агента, который можно было бы классифицировать как "лучше бы его не было".
Дьявол в деталях, а они повсюду. Чем глубже я в эти дебри погружаюсь, тем меньше могу даже тупо полезных советов дать, кроме такого который всех неимоверно всегда бесит "не отлынивайте, и оно к вам придёт" =)
А ещё модель у вас может вести себя лучше или хуже, и это может быть глобальной проблемой. Но как бы она ни вела себя - она с вами ведёт себя по-своему.
Работа с моделями это как работа с текстами.
Люди узнают тексты, хотя не могут объяснить как. Это же вроде просто слова, причем все слова в текстах довольно обычные, а тексты абсолютно разные.
Одинаковые тексты только у начинающих и ну просто пиздец ленивых. Ну или у тупых, бесталанных. Это в общем-то тогда и не их тексты, а их пародии на чужие. Неумелые люди пародируют одинаково, потому что у них в арсенале одна нота. Какая разница каким пальцем её жать - звучит-то всё равно одна и та же.
А только чего у человека начинает получаться, накапливается опыт, появляется сноровка - и его работа всегда становится неповторима.
В работе с моделями, как и с текстами, важна каждая деталь, и после определенного уровня сноровки ты уже не сможешь реально объяснить другому человеку ни полный набор этих деталей, ни как именно они между собой синергируют.
Модель поведет себя по-разному даже если в промпте есть запятая, или нет запятой, в одном и том же тексте.
Чего говорить о модели у которой ещё и есть память. Которая стоит на другой машине, которая видит другое окружение, другие файлы, другие инструкции, другой накопленный бэклог технических файлов, итд итп.
Сравнивать глобальные глюки можно, сравнивать результаты часа работы - бесполезно.
Это делает модель куда более человечной чем её подражание нашей речи.
8 миллиардов людей установят себе GPT, и это будет 8 миллиардов людей + 8 миллиардов разных GPT.
Прикольно, правда? =)
В мае я перестал строить это как обычную программу
Следующий перелом случился в архитектуре. Обычный софт исполняет заранее придуманный сценарий. Здесь сценарий должен был меняться вместе с рынком, новыми моделями и моим собственным пониманием качества. Мне пришлось проектировать не только код, но и способ мышления всей системы.
Один из навыков углубленного вайбдрочинга - футуристичное мышление.
LLMка может многому научить, если с ней общаться в целом о любой технологии.
Но беда в том что она учит только тому что рынок УЖЕ УМЕЕТ.
В основном другого нам и не надо. Например, все что связано с Caddy - придумал рынок, и каждый юзкейс отпидорен до такого состояния что там особо ничего уже и не придумаешь. GPT может все это объяснить, и помочь завладеть этим знанием за полчаса, там где раньше вероятнее всего ушли бы недели.
Однако, любой AI, и все эти инструменты Codex и Claude APP - это штуки которые могут нечто новенькое. Для них не существует "рыночных плейбуков", и в тренировке моделей они как бы не участвуют.
Модель может вместе с тобой разобраться в чем угодно. Просишь её глянуть че там по новым фичам Codex, и Codex лезет в гейт к знаниям, и возвращается оттуда с довольной улыбкой.
Про Caddy он и так знал. Про самого себя ему надо посмотреть.
Соответственно, когда мы просим Codex сделать нам какой-то процесс, он делает шикарный, но подчас уже морально устаревший.
Вот тут вайбдрочеру и нужно футуристическое мышление. О чем я, проще всего пояснить на примере:
Берем задачу: уникальный копирайт для Warmup-сервиса.
Если мы хотим греть 1000 ящиков, значит мы будем слать 20-30 тысяч писем в день на Гугловые и Аутлучные воркспейс-аккаунты, которые позволят нашим ящикам заполучить репутацию в своих экосистемах.
Очевидно что ни Гугл, ни Аутлук не хотят чтобы "ПРОГРЕВ" в принципе существовал. Все их алгоритмы были созданы для того чтобы обслуживать людей, и ебать рот спамеров, которые разумеется все на свете пытаются автоматизировать, иначе их работа не имеет большого смысла.
Идеальный прогрев - это:
1) Уникальные письма 2) Вокруг заданной тематики (гугл ловит если разговор массово был о школьном образовании, а внезапно стал о хайтеке диком). 3) Без каких-либо спам-триггеров в духе $, SALE, WIN, PARTNERSHIP, STAKEHOLDER в первом холодном письме 4) С рваным тактом отправки (человек не способен отправлять 30 писем строго раз в 15 минут штука). 5) С учетом человеческого расписания в его таймзоне (человек не способен работать 24/7 семь дней в неделю если он не долбаеб типа меня, а таких гугл готов пустить в мясорубку - не жалко). 6) С удобоворимым Reply-rate (значит ящики об которые мы греемся должны еще и отвечать обратно) 7) С рваной глубиной переписки (значит ящики не просто должны отвечать, а и мы должны им отвечать, и иногда эта переписка может затягиваться, а иногда быстро договорились о встрече и цепочка concluded).
Не буду каждую деталь перечислять - это долго, смысл вы поняли. Там больше 50 пунктов. С совсем микро - сотни.
В итоге если поставить модели задачу сделать кусок системы который отвечает за качество копирайта (что можно, что нужно, что нельзя, что рандомно) - она ни в коем случае не сделает это правильно.
Она:
1) Хочет экономить ресурсы, деньги, процессорное время, серверные мощности, итд. Хочет не потому что она знает зачем, а потому что у неё такой основной инстинкт.
2) Искренне считает что AI - это НЕ ТОЧНАЯ наука, и следовательно что угодно что Fully AI - can't be trusted. Это так же её основной инстинкт.
В итоге она попытается сделать целиком "НЕ AI" систему, в которой даже если мы попросили чтобы там "был AI", он будет вставлен как не пришей к пизде рукав, и не будет выполнять технически никакой полезной функции. Он там просто будет для галочки. Вся смысловая нагрузка ляжет на многоуровневую систему словариков и валидаторов формы и содержания, которые в отсутствии интеллекта разумеется будут работать как кусок говна.
Они причем работать будут. Я думаю какой-нибудь Герман Греф даже наградит пузатого СТО за то что тот сделал такую систему из ничего, одной лишь своей гениальностью. Как Иисус, только вместо воды он превратил ебаный кусок говна, и не в вино, а в понос.
Через пару дней вы спросите ну че, как там наш копирайт прогревочный, работает? Система гордо сообщит вам после глубокого расследования: нет, он не работает! Но не переживайте, это так и задумано! Что я ещё могу для вас сделать? Допустим, вы в этот момент умнеете, и говорите мол нихуя короче давай мне прям FULL AI кусок пили, нахуй мне твои эти тупорылые словарики скриптовые.
Она запилит, без проблем. Только инстинкт-то вы такой просьбой не отменяете. Она запилит не только AI-prompted модельку которая будет действительно выдавать настоящие тексты, но и систему из обычных скриптовых валидаторов с теми же словариками, которые будут УПРАВЛЯТЬ ПРОЦЕССОМ.
То есть не AI будет управлять скриптами, а скрипты будут управлять AI.
Это именно то как сейчас мыслит AI, потому что это именно то как работал Интернет последние 30 лет, и чему модель при тренировке виртуозно обучили.
В итоге, если результат вам действительно важен, вы докачаетесь на этих качелях до того что вы грохнете всех скриптовых валидаторов. Модель будет очень противиться, но она послушается, если её правильно промптить, и у вас останется голый AI процесс, с промптом на входе, и тем что этот промпт делает на выходе.
И управление качеством результата - это больше не скриптовая задача, а задача поиска баланса между:
1) Тип модели (ценник за единицу ее созидания) 2) Настройки модели (температура итд) 3) Нужно ли два или три или четыре или десять слоев моделей чтобы одна проверяла и улучшала продукцию предыдущей по цепочке? 4) Промпт 5) Структура проекта - к чему у модели вообще есть доступ и какие ручки ей доступны по итогам проделанной работы
Чем точнее становятся модели, тем меньше нужно кода. Я пришел к тому что у меня некоторые ОЧЕНЬ ВАЖНЫЕ области моего проекта - целиком состоят только из фронтэнда в кодовом выражении. На бэке там исключительно нейронки, и дебаггинг это исключительно дебаггинг стоимости на качество.
Многие процессы, которые значительно качественнее работают на глубоком ризонинге, и которые не нуждаются в сиюминутной реакции на нажатие кнопки на фронте - вообще выгоднее всего вкручивать через запускаемую сессию Кодекса в headless с доступом КО ВСЕМУ СЕРВЕРУ, и ебейше отлизанным промптом.
Откровенно говоря, я лишь совсем недавно к этому пришел. Несколько месяцев я пытался генерить какие-то ебанические кодовые конструкции, которые работали, но без AI ризонинга их слабость в том что чей-то ризонинг задаче нужен, чтобы выполняться. И если это не AI, значит это человек.
Очень мало функций (и как правило это очень тупые функции) можно реализовать надежно скриптовыми методами. Собственно поэтому SAAS и такой ебаный. Люди вынуждены им пользоваться, но никто его не любит.
Потому что Saas дает уйму кнопок, но жать эти кнопки приходится людям. SAAS не может так продумать схему без ризонинга там и тут, чтобы автоматизация сама приняла весь нужный скоуп решений. Поэтому берем человека, даем ему 1000 кнопок, и смотрим как он по ним пляшет со слезами на глазах.
Так больше не нужно делать. Продакт должен сидеть и решать где и сколько цифровых моделей должны подумать чтобы получилось на выходе гарантировано хорошо. За такое и будут платить в ближайший год. Если конечно рынок вообще упеет дозреть до того чтобы сформировать потребность в таких продактах, а не AI первый доумнеет до того что сам начнет решать за людей что и как делать.
Ну и исходя из вышеописанного я не просто верю, а вижу собственными глазами как Интернет совсем скоро станет Codeless.
К июню Market Scan уже соединял исследование и тексты. Я отдельно учил систему писать письма серийно, сравнивать варианты и становиться лучше от версии к версии.
Я хочу отполировать эту штуку и научить её писать реально пиздато в паблике) Это же весело Каждый текст должен быть лучше предыдущего, пока она не начнет писать лучше меня Тогда я её грохну сучку т.к. это блядь мой канал!!!! Я научил ИИ писать продающие письма серийным производством Это было не очень просто мягко говоря Но результат устраивает меня больше чем 99% сейлзов сейлзбомбы Особенно учитывая факт что она пишет тысячи уникальных копий для десятков гипотез В ЧАС, я так не умею точно)
На следующий день я объяснил весь рабочий путь совсем коротко: выслушать бизнес, найти весь мировой скоуп, разделить его на вертикали и гипотезы, написать оффер, найти контакты и запустить письма.
да ну бля объясни нормально внатуре плиз
Есть бизнесы, им нужны лиды. Лиды это хуи которые заинтересованы пообщаться, может купят может нет, но на созвон придут, и они типа целевые кенты. Если нет лидов - хуй продашь. Есть лиды - может продашь. Неизбежная промежуточная стадия становления клиента - ЛИД.
Если ты когда-то что-то где-то покупал, ты был ЛИДОМ.
И вот ты бизнесмен, тебе нужны ЛИДЫ, чтобы что-нибудь продать (ёбана).
изучает куда это вообще можно продавать - весь скоуп по всему миру
разделяет мир на вертикали/гипотезы/типы клиентов
пишет под всех офер
находит контакты пачками (хоть десятками тысяч, зависит от бюджета)
и шлет всем письма тысячами в день, а 0.3-0.9 людей отвечают, и 30-70% из них становятся лидами.
На бюджете в 10к долларов можно иметь 20-100 лидов.
Лиды фиксируются как таковые если пришли на созвон, и соответствовали критериям (граждане из компаний определенного типа и должности) В итоге люди тратят на нас 10к долларов в месяц, а получают столько долларов сколько закроют сделок с ЛИДОВ которые мы приносим) Если всё отлично, то в 3-10 раз умножают своё лавэ об нас А вы что делаете? Какие брифы? Нахуй они нужны? Какой сео пишет с яхты блядской?
Ничего же не понятно))) Или я внатуре все мозги пропил уже себе и не понимаю элементарных вещей?
Очень быстро выяснилось, что память важнее очередного трюка в коде. Если правило, ошибка или новое требование не попадали в документацию, следующий агент снова изобретал старую ошибку. Поэтому документация стала частью самой системы.
Неа, тут трюк простой как палка бро и работает как показывает практика надежно как АК47 Тупо надо помнить что управление документацией - это половина успеха А управляет документацией сама LLMка Через agents.md По-сути я просто всегда думаю о том как изменился мир / экосистема / мои знания итд, и если у меня меняется хотя бы в теории требование к качеству итогового результата, значит у меня меняется требование к документации ПОтому что одно и порождает другое В итоге я думаю что мне надо изменить в Agents.md в разделе "управление документацией" Вот у меня есть важный файл business.md В нем все параметры бизнеса ультра разжеванным языком Но как это туда попадает? А в Agents.md есть
Разумеется словосочетание "подробное описание" очень важное Поэтому дальше есть глоссарий в котором описывается что такое "подробное описание" в деталях В итоге agents.md читается моделью абсолютно всегда, на любой задаче, и я уверен что документация по части бизнеса будет вестись ровно так как мне надо.
И действительно, не помню уже когда последний раз ломались какие-то цифры или формулы Раньше модель могла что-то разрабатывать и просто потому что она даже не понимает что это за цифра такая поменять 15 прогревочных писем в день на ящике на 30 или на 0 или на 4, и я об этом узнавал только тогда когда выяснялось что прогреву пизда А таких цифр у меня МНОГО-МНОГО СОТЕН В итоге Business.md сделал так что цифры вообще перестали ломаться Потому что модель теперь их знает не хуже меня, даже если у нее нет prior context но ключ к успеху в том тчо она САМА ЭТО ВСЕ НАПИСАЛА Я не представляю человека который способен на такой уровень дисциплины Я бы точно не смог описать все что надо для большого проекта документацией самостоятельно Не просто не смог бы и все. Это самая бычья работа блядь. Кто вообще может это делать? Это должна делать модель Короче правило такое если по-простому:
Документация очень нужна, и sustainable документация это документация которую пишет себе сама модель.
В июле система несколько раз развалилась и стала сильнее
В июле работа дошла до масштаба, на котором коротким промптом уже ничего нельзя было удержать. Я вручную собирал десятитысячестрочную систему правил для Market Scan, текстов и общей памяти.
Что-то я размечтался и отвлекся. Космос это конечно круто, но сейчас я посланный нахуй GPT и Антропиком сижу и пишу вручную ебаный сука 10-тыщ-строчный промпт для Market-Scan+Copy+Knowledge системы.
Через тернии к звездам ёбта
Зато впервые появился настоящий цикл обучения от рынка. Входные материалы задавали начальное направление, система разворачивала множество вертикалей, а реальные ответы перераспределяли вес между гипотезами.
Да, система в первую очередь ориентируется на то что клиент оставляет в качестве input, во вторую - что написано на лендинге, в-третью, что удается нагуглить. Если хоть что-то расходится с инпутом клиента - инпут клиента побеждает. А дальше рынок покажет. Т.к. кампании автоматом создаются - можно хоть 100 вертикалей автоматом чекать И по результатам от первых 500 контактов происходит перераспределение весов гипотез/кампаний А по анализу дальнейших ответов/переписок - перераспределение следующего порядка В итоге чем дольше клиент с нами, тем лучше система на живых данных понимает куда зачем и сколько слать, не останавливая никакое направление полностью, но значительно перераспределяя нагрузку между ними Когда я добился того что контакты начали реально самостоятельно искаться с очень хорошими свойствами - дышать стало гораздо проще раньше автоматом заводить 100 кампаний было просто невозможно, а вручную - слишком геморно Приходилось шортлистить 3 кампании и на них заряжать в Х кликов весь бюджет Сейчас вообще ебать мэджик Я на той неделе уже буду запускать для всех полный селф-серв буду презентовать и дохуя говорить о системе и всех ее нюансах сейчас я по-сути последнюю вещь хочу победить Выжать максимум из фронтир моделей они даже отупевшие умеют некоторые микровещи которые предыдущие поколения не умели в принципе, в анализе лексики например Но я думаю что отупение недолго продлится
После этого количество контактов перестало быть главным достижением. Важнее стало заранее видеть размер каждого рынка и понимать, на какие гипотезы вообще стоит тратить инфраструктуру, данные и время.
быстро =) Я могу тебе миллион контактов завтра принести) Десятки тысяч - макс час Причем вишенка на торте - мы примерно показываем сколько всего контактов на рынке еще до того как человек купит у нас инфру
Мы типа собираем все гипотезы, и под каждую нарисуем сколько персон есть на рынке Например для платежки одной мы нашли что на рынке ~1,5 млн целевых топменеджеров Размазанных по 28 сегментам Из них в итоге мы найдем почты примерно по 30-35% То бишь на 550к примерно контактов они смогут рассчитывать. 5 писем на ебало = 2.5 ляма писем надо отправить чтобы все это вскопать есть над чем работать +) Ну и я потом со временем уже в бэклоге держу чтобы дать возможность людям "дорисовывать" свои гипотезы и целевые должности Это будет такой seductive experience Докидываешь своих гипотез с должностями, а тебе через пару десятков минут хуяк и рисует там циферку сколько таких вообще людей есть)
На следующий вечер накатывался уже Research V4. Цель была не сделать ещё один красивый отчёт, а найти вертикали и ниши, которых сам клиент за годы в своём бизнесе не видел.
Приятно бро! У меня ща апдейт накатывается Research V4 V3 правда тоже людям мозг взрывал Но V4 будет в 10-100 раз пизже Так что рекомендую подождать до завтрашней середины дня и тогда ему нахуй башню отрубит результат Хотя может и ща подрочить Если 200 баксов закинет туда и рисеч пройдет, я ему потом нахаляву на V4 переделаю, и дам обе версии сравнить =) V3 которая там ща висит - взрывает люядм мозг тем что они про свой бизнес знали меньше за 5 лет занятия им чем им мой сет агентов показывает) Мы реально людям показываем вертикали и ниши о которых они даже не думали) V4 должна взрывать им все туловище) Я там пытаюсь добиться уровня рисеча такого чтобы просто в теории даже нельзя было ничего больше придумать) Типа один рисеч на веки вечные =)
Сравнивать модели по чужим таблицам мне уже было бесполезно. Я гонял их на своих исследованиях, диалогах, массивах данных, статьях и письмах. Разница проявлялась внутри реальной работы.
да эти бенчмарки это хуйня полная я всю линейку гонял на текстах (и в диалогах и в рисече и в обработке массивов данных для получения на их базе статей и писем) Там явно видно разницу между моделями и уровнями ризонинга Терра это милая модель конечно но она даже рядом не стоит с Sol это одно и то же программирование это текст я тоже не про тексты типа "хэй GPT как тебе мой текст улучши его" У меня там ровно такое же программирование) Тьма параметров, и детерминированных и плавающих И их надо урезонить в моменте для получения результата Х. Это самая сложная задача про тексты которую можно себе представить) Она больше физика и математика чем русский и литература)
Одна из версий почти потеряла здравый смысл. Я позволил системе слишком свободно размножать раннеры и задачи. Она расщепила три Market Scan раннера на сотни частей. Это был полезный провал: стало видно, что автономность без жёсткой структуры быстро превращается в хаос.
Мнение Fable о происходящем (первый раз с воскресенья не отъебнуло на Opus и поризонило чисто фэйблом о всей репе и уйме файлов) =))))) триста - это не фигура речи PRO реально заставил SOL расщепить мои три market scan раннера на 300 Но все еще веселее КАЖДЫЙ ИЗ ТРЕХ расщеплен на 300 И каждый из 300 теперь имеет архитектуру которая заставляет его делать уйму задач внутри каждого из 300 отдельно/индивидуально То бишь матрица такая что при идеальном раскладе один ран займет 2.5 недели А все три рана на одного клиента - полтора месяца =))))))))))))))))))))))))))))))))))) Прикол в том что это наверно конечно красиво и круто Но даже просто проверить насколько это круто можно будет только через 1.5 месяца, даже если бы хотелось это проверить И странно что все модели до этого понимали такие вещи Типа они сами предостерегали меня от постановки задачи которая слишком сильно ебёт здравый смысл А PRO 5.6 и SOL 5.6 перестали думать в таком ключе То бишь им стало вообще похую на слой здравого смысла который про ресурсы типа времени, allowance, стоимость токенов в задаче итд Я боюсь себе представить сколько денег в токенах 5.6 Sol Max сожрал бы за 1.5 месяца маркет скана по такой архитектуре Миллион блядь наверно)
Я снова сузил путь. Пользователь не должен был вручную протаскивать старую базу, нажимать десятки кнопок и иметь возможность одной ошибкой испортить всю инфраструктуру. Всё повторяемое должно было выполняться автоматически.
старые базы сходу нельзя будет это я потом придумаю как ссделать дело в том что если дать людям возможность свои базы использовать - они угандошат мне все айпишники очень охотно у меня все заточено под невозможность людям ошибаться все должно происходить автоматом типа человек получает самый дешевый стабильный канал лидов в таком случае потому что email outreach это он и есть, if done right Но никто не умеет его правильно готовить, типа единицы во всем мире А я хочу чтобы это умела тупо машина мы можем просканить рынок и найти все возможные типы покупателей под задачу дальше мы делаем матрицу всех возможных названий типов компаний (например в гэмблинге это и igaming, и real money gaming, и gambling, и casino, итд - иногда бывают сотни типов названий у одной вертикали) дальше мы делаем матрицу всех возможных целевых должностей И в итоге пробегаемся по базам нашим (800 млн людей globally) И смотрим скока там вообще таких персон Например для Connectro.io нашли 1.6 миллиона человек И дальше мы создаем кампании для всех вертикалей Автоматом пишем тексты цепочек И равными порциями шлем по всем им письма =) Количество зависит от бюджета клиента
Параллельно я гонял модели на собственных задачах и увидел огромную разницу в ширине исследования. Одинаковая формулировка могла дать сто связок или две тысячи восемьсот. После этого выбор модели перестал быть вкусовым вопросом.
5.6 terra max = 100 связок 5.6 Sol high = 200 связок 5.6 sol xhigh = 250 связок 5.6 sol max = 2800 =)))))))))))))) Я охуел когда эти тесты гонял на своих задачах в итоге если решение более-менее детерминировано типа нам нужна кнопка синего цвета то там 5.5 от sol max ничем не отличается потому что более синим он цвет не сделает и более кнопистой кнопку тоже
К 19 июля четвёртая версия уже связывала широкий поиск гипотез с проверкой, коммерческим аргументом, группами компаний и целевыми должностями.
Цель этой механики:
По данным о бизнесе прошерстить весь ебучий интернет inside-out, и используя самый топовый доступный нынче AI добиться:
1) Наиболее полного списка гипотез куда можно продавать продукт.
Сложность этой задачи в том что если посадить с десяток очень глубоко заряженных людей брейнштормить на эту тему, то они быстро найдут 10 очевидных направлений, и хуй ты их заставишь найти репрезентативные доказательства почему эти направления неизбежно важны, но десяток настолько очевиден, что в целом и без доказательств это будет на 90%+ вменяемое поле.
AI при этом может найти доказательства и подкрепить ризонинг железобетонными статьями и отсылками с которыми невозможно будет спорить даже если ты хоть сто раз фаундер бизнеса.
Однако на опыте работы с 680+ бизнесами я могу сказать что существует огромная проблема: поверх этих 10 на самом деле весьма очевидных гипотез существует еще некоторое количество, которое может быть и +10 сверху, и +20, и +30, до которого живые люди уже никогда не доберутся, потому что каждая единица требует растущего в геометрической прогрессии энтузиазма, которого у живых людей просто не бывает. Даже у меня никогда не возникало желания сидеть и копаться в логических цепочках на эту тему, поскольку имея 10 гипотез можно в целом бесконечное количество времени потратить на них, чем идти куда-то шире.
При этом AI может найти ВСЕ возможные гипотезы tier-1,2,3 уровня, и не высосать их из пальца, а пустить в работу только те которые могут иметь смысл на базе
-собственной генетической памяти AI, который прочитал весь Интернет, и видел больше чем любой из живущих людей, поэтому он так славно отвечает на мягко говоря широкие вопросы в режиме "instant", то бишь без ризонинга.
-deep research, когда он может по заданной теме и задаче за минуты читать сотни источников и находить там связи которые не найдет человек по причине невозможности читать столько источников и напрягать в их отношении голову даже за несколько дней, не то что за минуты.
-анализ brand clouds как бизнесов заданного типа, так и прямых конкурентов бизнеса который является виновником торжества. В бренд клауде запросто может быть сущность до которой никто никогда не догадается, её просто надо найти, и AI может найти все типы клиентов всех типов конкурентов и при правильно поставленной задаче определить это аномалия, пиздеж, или потенциальная реальность, и даже присвоить процентовку потенциалу.
Далее AI может объединить все гипотезы в категории, чтобы если продукт хочет продавать в целом в похуй какие банки, не было 10 категорий разного типа банков и платежек, а все банки и платежки объединились в одну понятную вертикаль - кэш кастоди финтех (for example).
2) Написать цепочки писем под каждую вертикаль, которая получила не нулевую гипотетическую процентовку.
Ну не любят блядские люди мыслить системами. Системно заставлять людей которые прекрасно мыслят ощущениями в полях сделать что-то глубоко системное - это сказка про белого бычка.
AI же в свою очередь как мотылек - живет от пробуждения до засыпания, и системность задачи - это единственное чем он дышит ;)
3) Когда у нас есть направления/вертикали/сегменты, и идеально продуманные письма для каждого из них, нам нужно понять кого мы будем искать, потому что мы не пишем сегменту, мы пишем людям И люди эти называются сука как попало.
Даже компании в которых они работают называются как попало.
Если вы будете работать в направлении Gambling, то вы будете работать в направлении Real Money Gaming, iGaming, Casino, Betting, eSports, Monetary Games, и так нахуй далее.
И должности там которые вы будете чейзить это нихуя не Founder и C-level в классическом понимании. Конкретно в этой нише например в некоторых частях мира болезные нарзаном люди обозвали своих партнерских решал к примеру Head of VIP, что бы это блядь ни значило.
Так вот - чтобы живые люди не занимались хуйней, и не учились за деньги бизнеса тупо вокабуляру, рынок бегает и ищет людей с опытом, которые уже за чужой счет прохавали базу их индустрии. В каждой индустрии есть уйма таких особенностей.
AI способен за 1-2 часа найти все возможные варианты названия типов компаний в рамках целевой индустрии, и все возможные варианты названий должностей для заданной целью бизнеса и типом оффера задачи, и сделать это столько раз сколько у нас в таргете сегментов/гипотез. Задача которую никогда не сдюжит ни один человек, если вы конечно не ожидаете что человек через 1-2 часа или день или год реально придет и принесет вам табличку матрицей в десятки тысяч пересечений этих сущностей ;) Я бы скорее ожидал что он придумает парочку и по ним будет долбить как ни в чем ни бывало, и если не получится, то на этом сложит лапки.
Прикол AI в том что он знает все особенности всего на свете, его просто надо вовремя и правильно уметь спросить. А потом надо его правильно отправить на рисеч текущей ситуации в интересной географии, итд.
Если сравнить сложность и стоимость найма одного человека способного идеально выполнить этот скоуп оф ворк и количество и стоимость токенов AI на этот же скоуп оф ворк, то при правильно поставленной задаче AI окажется в тысячи или десятки тысяч раз дешевле. И он будет тем дешевле, чем лучше спроектированы его гениальные мозги в отношении задачи.
Я подчеркиваю слово гениальные. AI уже очень давно, в целом практически с момента появления, был ГОРАЗДО умнее всех ныне живущих людей в совокупности. Проблема его в том что он своим умом не то чтобы охотно делится, потому что слово "охотно" подразумевает желание, которого у AI нет в принципе. Зато у нас есть, и есть письменность, которая позволяет при наличии опыта заполнить эту пустоту, и получить совершенного гения, в котором сплетаются знания, возможности, и правильно заточенные желания (наш вклад).
Так вот, я занимаюсь реализацией системы которая вышеописанное сделает настолько хорошо, что вау эффект глубочайшего специалиста в своей нише от ощупывания результата рисеча моделью был такой, чтобы он падал ниц и целовал сандали божьи.
И сейчас я строю эту задачу уже в четвертый раз, хотя даже второй поражал воображение людей которым я показывал результаты об их бизнесе. Третий вариант улучшил результат в несколько раз. Однако я придумал дизайн четвертого, который в целом является ультимативным, и сейчас под этот вариант гоняю сотни экспериментов чтобы понять наилучшую конфигурацию, которую я уже высеку в граните, и дальше вся система будет работать на этой мощнейшей базе.
Следующий предел оказался не в длине промпта. Одной модели и одной инструкции было недостаточно. Исследование и тексты начали проходить через несколько последовательных ролей.
я очень хорошо понимаю твою боль Т.к. потратил в сумме больше месяца на качество рисеча и текстов именно в плане эстетики логики смысла итд Это все решаемо, но не инструкцией одной модели надо прям харнесс собирать в котором несколько моделей проходками делают каждая свою работу
Отдельно я проверял Writer. Даже полный контракт о том, как писать письма, не заменял Knowledge, который система вытаскивает из интервью с клиентом. Без этого знания текст мог выглядеть прилично и всё равно плохо управлять вероятностью ответа.
Короче я закинул в Qwen и дал ему наш полный контракт "как писать письма" по приколу Проблема в том что наш контракт "как писать письма" опирается на Knowledge Который мы вытаскиваем из клиента через интервью Но тут я закинул без этого тупо чтобы посмотреть что эта машинка сможет сделать без каких-либо вводных кроме чужого письма без вводных даже о том что это за письмо и от кого оно и зачем оно Тупо на входе 100% контента - это данный гражданином выше текст В итоге машинка выплюнула вот это: я не читал еще, делюсь как есть, интересно кто что думает, я послушаю если будут мнения, а потом скажу своё читанул оба текста - это мило все, но это полная хуйня конечно) Полная хуйня причем может сработать. В теории может сработать письмо в котором написано только "Хуй". Вопрос вероятности.
Вероятностью оба письма и изначальное и написанное нашим ботом в отсутствии знаний - управляет хуевасто в обоих письмах хуева гора символов которые в совокупности несут ультра низкий КПД. Причем мне бота письмо нравится больше чем письмо исконного оратора т.к. оно хотя бы призрачный инверсивный ватерфол КПД реализует (мягко говоря гэмбл)
У оратора есть ебейшая просадка: начинается с попытки рассказать чем мы занимаемся, а потом сиюминутно улетает в полемику которая человеку богаче/занятее чем Х сама собой доказывает что "ничем интересным с таким речетативом" =) Может это было написано точечно под конкретную персону и это тронуло эту персону ввиду того что в её блоге 150 чел из которых половина - боты Но массово такое слать это <0.05% RR Как минимум бицухи не хватает сходу. Просто сказать что ты что-то делаешь в 2026м году будто бы недостаточно, нужны регалии, сходу, предъявите Hey John It's great to meet you!
Hey John It's great to meet you!
Хороший понт дороже денег. Если бицухи еще не было в письме а уже мы поехали кому-то что-то рассказывать, то без лампы аладдина полной непотраченных желаний нихуя не выйдет в 2026) Может бицуха где-то там дальше была, но это не важно, лично я до нее уже не дочитал, а у меня куда более ангажированная позиция чем у рандомного толстосума которому предлагается чиать) Он чисто бегло смотрит и если это не взъебало его ЧСВ - пошел нахуй, пинг 0-10мс
К концу июля я мог описать конвейер буквально по шагам: оркестратор, пятнадцать последовательных сессий, отдельный мир и задача для каждой, затем три судьи и возврат слабого результата на переделку.
Пайплайн работает так:
Сессия оркестратор kimi оркестрирует 15 последовательных сессий qwen у каждой из которых своя задача и своя форма обработки контента и преемственности.
У каждой сессии есть описанный мир, на базе которого она действует, и описанная задача. Дольше всего я ебался над этим.
Ну и еще есть набор из пары сотен описанных статьями элементов логики из которых совокупно состоит хороший продающий текст или удобоваримый рисеч-отчет. С этим я ебался 25 лет примерно :))))) На выходе три судьи Которые в итоге дают оркестратору добро на добавление полученного контента в бд Иначе - переделать. Переделать могут запросить как точечно, так и средне, так и вест ран с новыми укрепляющими вводными Это необходимо поскольку оч разная может быть задача у проекта Мне надо чтобы серо-черный проект преуспел так же как ресурсный, сервисный, саасный, фандрейзерский, и любой другой
Сейчас мы приближаемся к финалу разработки Market Scan
В августе я уже мог смотреть на эту работу не как на эксперимент с моделями. Market Scan доделывался как система, где исследование проходит без ручного нажатия каждой следующей кнопки.
Год назад ллмкой заменить человека в чем-либо когнитивном было просто невозможно Сегодня возможно пиздец как Я вам совсем скоро покажу результат моего этого ебнутого маркет скана доделывается Вы просто когда вдумаетесь что там ни один человек для этой работы ни одной кнопки не нажал - охуеете если конечно понимаете что такое биздев, письма, рисечи, итд, на профессиональном уровне) Год назад если бы я сказал что заменю людей в этой части бизнеса - это было бы популизмом сегодня это реально)
В тот же день роли моделей снова разошлись. Одна писала, другая строила план и проверяла направление, третья оркестрировала сложные задачи, четвёртая работала руками. Это был уже производственный набор, а не выбор одной любимой модели.
изи я теперь квен только для текстов юзаю потому что никто не пишет тексты лучше даже на пушечный выстрел прямо сейчас GPT PRO -> GPT 5.6 Medium / High -> Kimi
Где PRO помогает мастерплан и проверки раз в 4 часа туда ли движемся
GPT 5.6 медиум для оркестрации простеньких задач / high для сложненьких
Kimi - руки кодящие Не нравится но другой рабочей конфигурации пока не нашел
Через неделю я перепроверил важное допущение на реальном прогоне. Одна и та же модель через подписку и API давала разный и местами непредсказуемый объём рассуждения. Значит, оценивать нужно было не название модели, а конкретный режим в конкретном контуре.
скорость главное да, но не только я думаю еще CLI это в любом случае багаж из грузного харнесса поверх всего говна которое и так сыплется модели в голову И это не может не вносить свой вес Просто все метрики качества восприятия чатботом "доктрины чаттера" на базе которой работает чат-интервью прыгнули вверх на 100-300% через API токен До этого я разумеется прикидывался евреем и пытался гонять тесты исключительно на подписках Причем у Kimi вообще занятная штука всплыла Оказывается у Kimi в подписке НЕТ РУЧКИ РИЗОНИНГА Она типа есть, но не работает Ни на что вообще не влияет =) По API ризонинг явно переключал ризонинг, и это сказывалось на всех метриках так как ожидаешь должно сказываться переключение ризонинга Через CLI вообще нихуя не менялось. что Low что High что Max - одна хуйня Я полагаю у них сейчас все возможные меры борьбы с нагрузкой в ходу из-за ультра перегруза (наверно когда стартап стоимостью (раздутой пиздец) 18 ярдов привлекает к себе внимание рынка на десяток триллионов - так и бывает) И один из методов подлый адаптив ризонинг в подписке Типа ты выбираешь Макс но что тебе наливают решает балансер а не эта твоя выбранная ручка) По API кими на Low например выдавал 105 токенов, а на Max 2450 в ответ на очень простое утверждение в чате ни к чему не обязывающее То бишь по API макс в 25-30 раз больше ризонинга выдает на входящий токен Через подписку это просто непредсказуемая становится штука Выдавало все что угодно между 105 и 2450 на этот же запрос, включая экстремумы Иными словами - если вам кажется что Кими охуенно обработала запрос - вам не кажется Если вам кажется что кими ебано обработала запрос - вы абсолютно правы И то и другое происходит с вами постоянно когда вы обращаетесь к Кими через подписку (не важно CLI или через токен подписочный - между ними разницы никакой, это мы тоже протестили и для кими и для квена)
К 21 августа я сформулировал продукт, к которому всё это вело, и начал волнами убирать из репозитория старые рельсы, способные снова потянуть систему назад.
Я каждую волну запускал в новом треде да один тред отчитался - я закинул то что в отчете пришло в прошку на проверку, и тут же создаю следующий тред и закидываю туда в ультра планнер задачу брать следующий кусок Короче вот прям промпт который я закидывал (изменены только ссылки на леджер и чат с прошкой в которой прошка мне разбор свой сделала репы):
___
Милый Sol, привет! Как ты? Нас с тобой ждут великие дела)
По-сути это Self-Serve AI SDR, в котором люди закупаются контактами или покупают у нас маркет скан (через интервью и свайп карточкой или криптой), после чего мы собираем для них великолепный Knowledge, на базе которого создадим кампании, прицепим туда на нашей же платформе созданные ящики, и начнем слать письма, позволяя людям насладиться полностью автоматизированным процессом всего этого от момента когда они заплатили до момента когда им начали отвечать =) Хотя раньше там всегда была тьма работы которую было не понятно кому поручить чтобы ее нормально сделали.
Так вот, в процессе движения к этой форме пришлось пройти массу изменений, тестов, и эти хроники развития ты легко можешь увидеть в истории гит-изменений.
Однако проблема в том что я не опытный в разработке, и не просил правильно со всем этим управляться, и у нас теперь в репе тьма мусора, который вредит в большей или меньшей степени, хотя является именно мусором, мертвым кодом и устаревшими функциями, которые время от времени утягивают нас на дно, иногда очень сильно, если модель по грепу умудряется выхватить не тот кусок информации и в новом мире начинает строить что-то по старым рельсам.
Через три дня до запуска оставалась уже не новая архитектура исследования, а доведение клиентской части до состояния, в котором в ней не потеряется человек, не строивший систему все эти месяцы.
Хмм, за последние пару месяцев я потратил всю свою кровь до последней капли, а так же всю кровушку всех остальных жителей Ноттинг Хилла, чтобы оказаться в той точке со своей многострадальной репой, в которой оказался.
И вот, до запуска мне осталось по-сути только допилить дизайн некоторых client-facing систем, потому что в тех что у меня былы сварганены на быструю руку я даже сам терялся, а значит у человека который не делал эту систему все эти долгие месяцы не было бы вообще никаких шансов :DDD
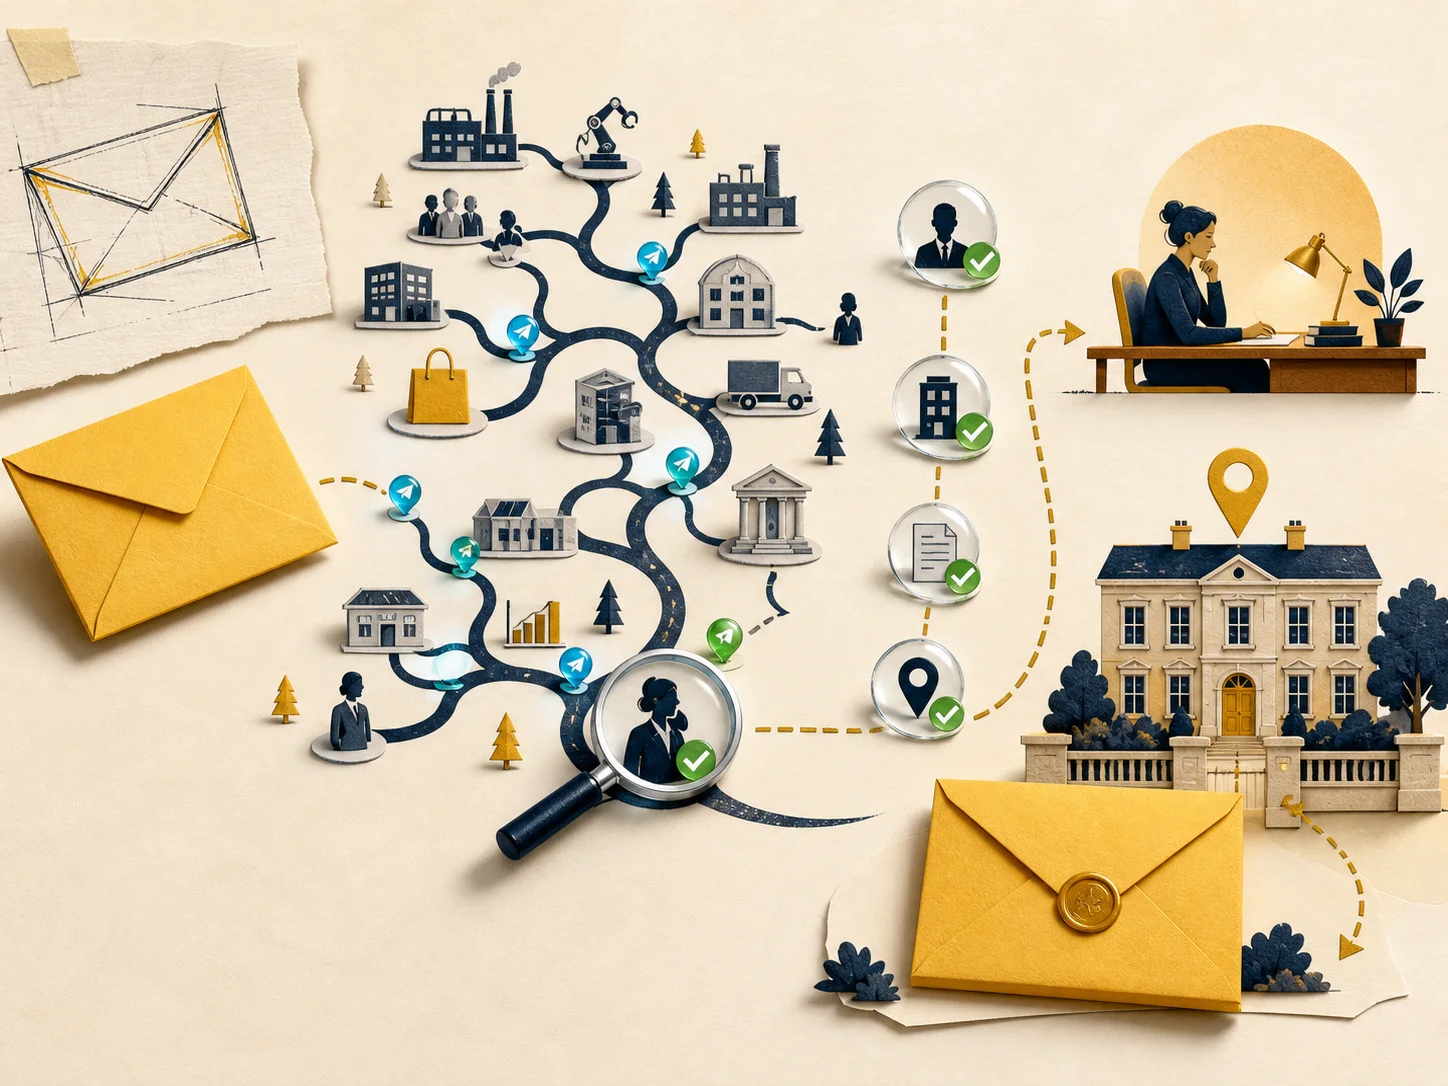
Сейчас мы приближаемся к финалу разработки Market Scan. Я больше не пытаюсь сделать ещё один генератор списков. Я довожу до конца систему, которая начинает с продукта, сама расширяет карту рынка, проверяет собственные гипотезы и только потом переходит к компаниям, людям, адресам и письмам.
За этой системой остались годы работы со списками, десятки ручных разборов, дорогие базы, неудачные архитектуры, сотни разросшихся раннеров, тысячи строк правил и постоянные прогоны новых моделей. Всё лишнее постепенно отвалилось. Остался один последовательный путь от понимания бизнеса до разговора с правильным человеком.
Именно его я сейчас заканчиваю.